
Microsoft planea comenzar a desplegar sistemas de inteligencia artificial Maia 300 de varios gigavatios en 2027, instalando potencialmente más de un millón de aceleradores personalizados, convirtiendo así su propio silicio en el motor principal para la inferencia de IA en todos sus productos y servicios. Según informó Reuters, esta magnitud supondría un cambio significativo en la capacidad de procesamiento de IA de Microsoft, pasando de los procesadores gráficos de propósito general a hardware diseñado específicamente para sus propias cargas de trabajo.
La compañía anunció el lunes que un rack Maia 300 con 96 aceleradores debería ofrecer un 40 % más de tokens por megavatio que los sistemas líderes basados en GPU, y hasta siete veces el rendimiento de tokens a escala de rack de su predecesor, el Maia 200. Estas son proyecciones de Microsoft, no pruebas de rendimiento verificadas de forma independiente: la compañía no identificó el sistema rival utilizado para la comparación del 40 %, y la implementación en producción no comenzará hasta el próximo año.
Este anuncio es importante porque la inferencia —el proceso de ejecutar un modelo entrenado para responder preguntas, escribir código o realizar una secuencia de tareas— se está convirtiendo en el principal coste recurrente de la IA comercial. Al controlar una mayor parte de ese hardware, Microsoft busca mejorar la rentabilidad de Copilot, GitHub, Foundry y sus propios modelos, al tiempo que reduce su dependencia de los aceleradores de Nvidia y AMD.
Un sistema construido en torno a la inferencia
Maia 300 no se presenta como una réplica directa de una GPU convencional. La información del producto describe un diseño centrado en la inferencia para contextos extensos, respuestas conversacionales rápidas y trabajo sostenido de agentes en múltiples pasos. Ocho pilas de memoria HBM4 de alto ancho de banda proporcionan 288 gigabytes de capacidad y 18 terabytes por segundo de ancho de banda máximo para cada acelerador dentro de un límite térmico de 950 vatios.
El diseño separa las funciones de computación, control de memoria y entrada/salida en chipsets. Los chips de computación utilizan el proceso N2P de Taiwan Semiconductor Manufacturing Co., mientras que otros componentes pueden emplear procesos de fabricación adaptados al ancho de banda, la conectividad o el coste. Esta segmentación permite a Microsoft reservar sus chips más avanzados para las tareas en las que espera obtener la mayor mejora de la eficiencia.
El movimiento de datos es el objetivo principal de la ingeniería. la descripción técnica , el chip utiliza un flujo de datos dirigido por software y una distribución de memoria no uniforme para mantener la información cerca de los procesadores que la necesitan. Los formatos de menor precisión reducen aún más la cantidad de bytes transferidos por cada token generado. Este enfoque está diseñado para solucionar un cuello de botella común en la inferencia: alimentar las unidades de cómputo con los parámetros del modelo y el contexto guardado con la suficiente rapidez para mantenerlas ocupadas.
Los estantes se convierten en la unidad de competencia
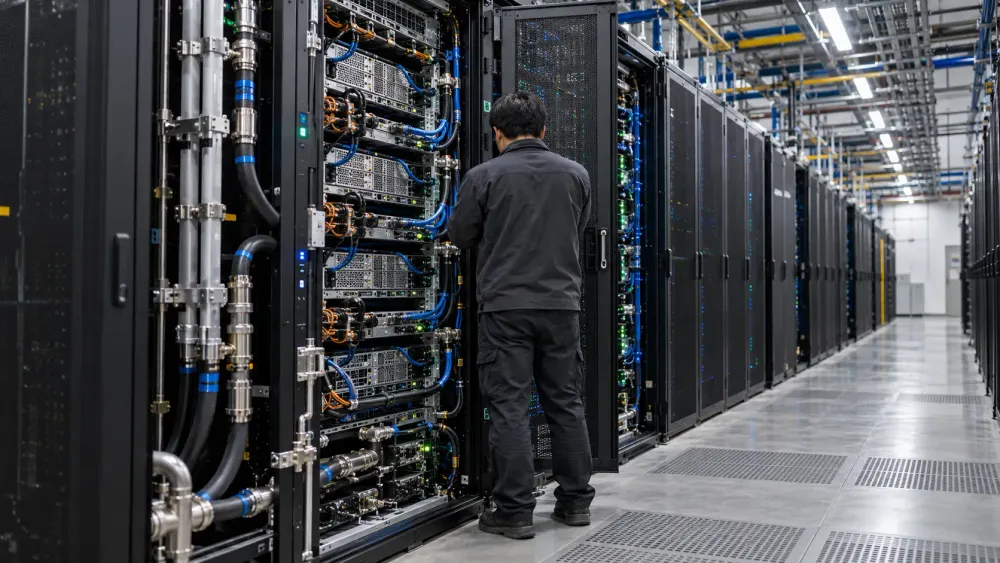
Cada rack Maia 300 combina 96 aceleradores en 24 bandejas con refrigeración líquida y consume hasta 167 kilovatios. El rack completo contiene 27,6 terabytes de memoria de alto ancho de banda y 1,7 petabytes por segundo de ancho de banda de memoria agregado. Microsoft afirma que la refrigeración líquida elimina más del 80 % de la carga térmica del rack, mientras que la refrigeración por aire convencional se encarga de los componentes menos exigentes.
La red es igualmente importante. Un rack forma un módulo, y se pueden conectar hasta 128 racks para formar un "supermódulo" de 12 288 aceleradores. Microsoft utiliza transporte basado en Ethernet y un modelo de comunicación común entre racks, lo que permite que las tareas de gran tamaño abarquen todo el hardware sin necesidad de enrutar cada transferencia a través de un sistema host independiente. Esto convierte a Maia 300 tanto en una arquitectura de centro de datos como en un chip.
La cifra de 167 kilovatios es superior a los aproximadamente 142 kilovatios que Reuters citó para un rack Nvidia GB300 de 72 GPU. El argumento de Microsoft se basa en la producción por unidad de potencia, no en un menor consumo del rack. Esta distinción es crucial, ya que las empresas de servicios públicos y los operadores de centros de datos se enfrentan a conexiones de red limitadas: un hardware más denso solo genera valor si la capacidad de procesamiento adicional realizada dentro de una asignación de potencia fija compensa la mayor carga de cada rack.
Microsoft busca controlar los costos recurrentes de la IA
Microsoft ya utiliza Maia 200 en producción para Copilot y el desarrollo de sus modelos internos, y se espera que GitHub Copilot y Microsoft Foundry sigan su ejemplo. Según The Verge , Maia 300 está diseñado para convertirse en el sistema de inferencia principal de los servicios de Microsoft, un rol mucho más amplio que el de un programa acelerador interno limitado.
El momento elegido refleja tanto la demanda como la presión del gasto. En su última conferencia sobre resultados, Microsoft informó de gastos de capital trimestrales por valor de 41.000 millones de dólares, de los cuales aproximadamente dos tercios se destinaron a activos de vida útil más corta, principalmente CPU y GPU. La compañía prevé unos 175.000 millones de dólares en gastos de capital para el año natural 2026 tras una reclasificación de arrendamientos relacionada con la contabilidad, mientras que la demanda de Azure sigue superando la capacidad disponible.
El uso de chips personalizados no elimina a los proveedores externos. Microsoft sigue ofreciendo una plataforma Azure heterogénea y continúa adquiriendo grandes volúmenes de GPU. Su estrategia consiste en reservar el hardware adquirido para aplicaciones donde la flexibilidad o la compatibilidad son cruciales, mientras que dirige la inferencia interna predecible y de alto volumen hacia Maia. Si la utilización es alta, el control sobre el software, la red y los chips puede reducir los costos por token y la dependencia de un único proveedor de aceleradores.
Las afirmaciones aún necesitan pruebas en el mundo real
Las cifras más importantes siguen siendo prospectivas. Microsoft no ha publicado resultados detallados de cada carga de trabajo, costes de adquisición, tasas de fallos ni comparaciones auditadas con sistemas rivales específicos. El rendimiento siete veces superior al de Maia 200 también combina varios cambios, como el doble de aceleradores por rack, mayor ancho de banda, nuevos formatos de precisión y un mayor consumo energético; no se trata de una simple comparación de rendimiento entre chips.
El despliegue a escala de millones de chips también conlleva riesgos en la fabricación, el suministro de memoria, las redes y la refrigeración. La avanzada capacidad de procesamiento de TSMC y el suministro de HBM4 influirán en la rapidez con la que Microsoft pueda fabricar sistemas, mientras que el soporte de software determinará si los modelos funcionan de manera eficiente en la nueva arquitectura. Un diseño sólido sobre el papel puede, sin embargo, perder capacidad debido a una baja utilización, sobrecarga de programación o herramientas inmaduras.
Qué pondrá a prueba el lanzamiento
Maia 300 marca un cambio estratégico: de experimentar con aceleradores personalizados a convertirlos en infraestructura central. El lanzamiento en 2027 pondrá a prueba si Microsoft puede traducir el control arquitectónico en reducciones cuantificables de costo y consumo de energía por respuesta de IA útil, sin limitar la elección de modelos ni la confiabilidad del servicio.
La evidencia más clara llegará después de que comience la producción: tasas de utilización, disponibilidad para los clientes, datos de rendimiento comparables y la proporción del tráfico de inferencia de Microsoft transferido a Maia. Por ahora, el anuncio establece la escala prevista y la dirección técnica. Sin embargo, aún no demuestra la ventaja de eficiencia que, según Microsoft, justificará dicha escala.












